Quando il modello impara dai suoi errori
I testi generati finiscono in rete, e la rete è il materiale di chi addestra. Il giro che restringe la varietà, e perché conta avere materiale proprio.
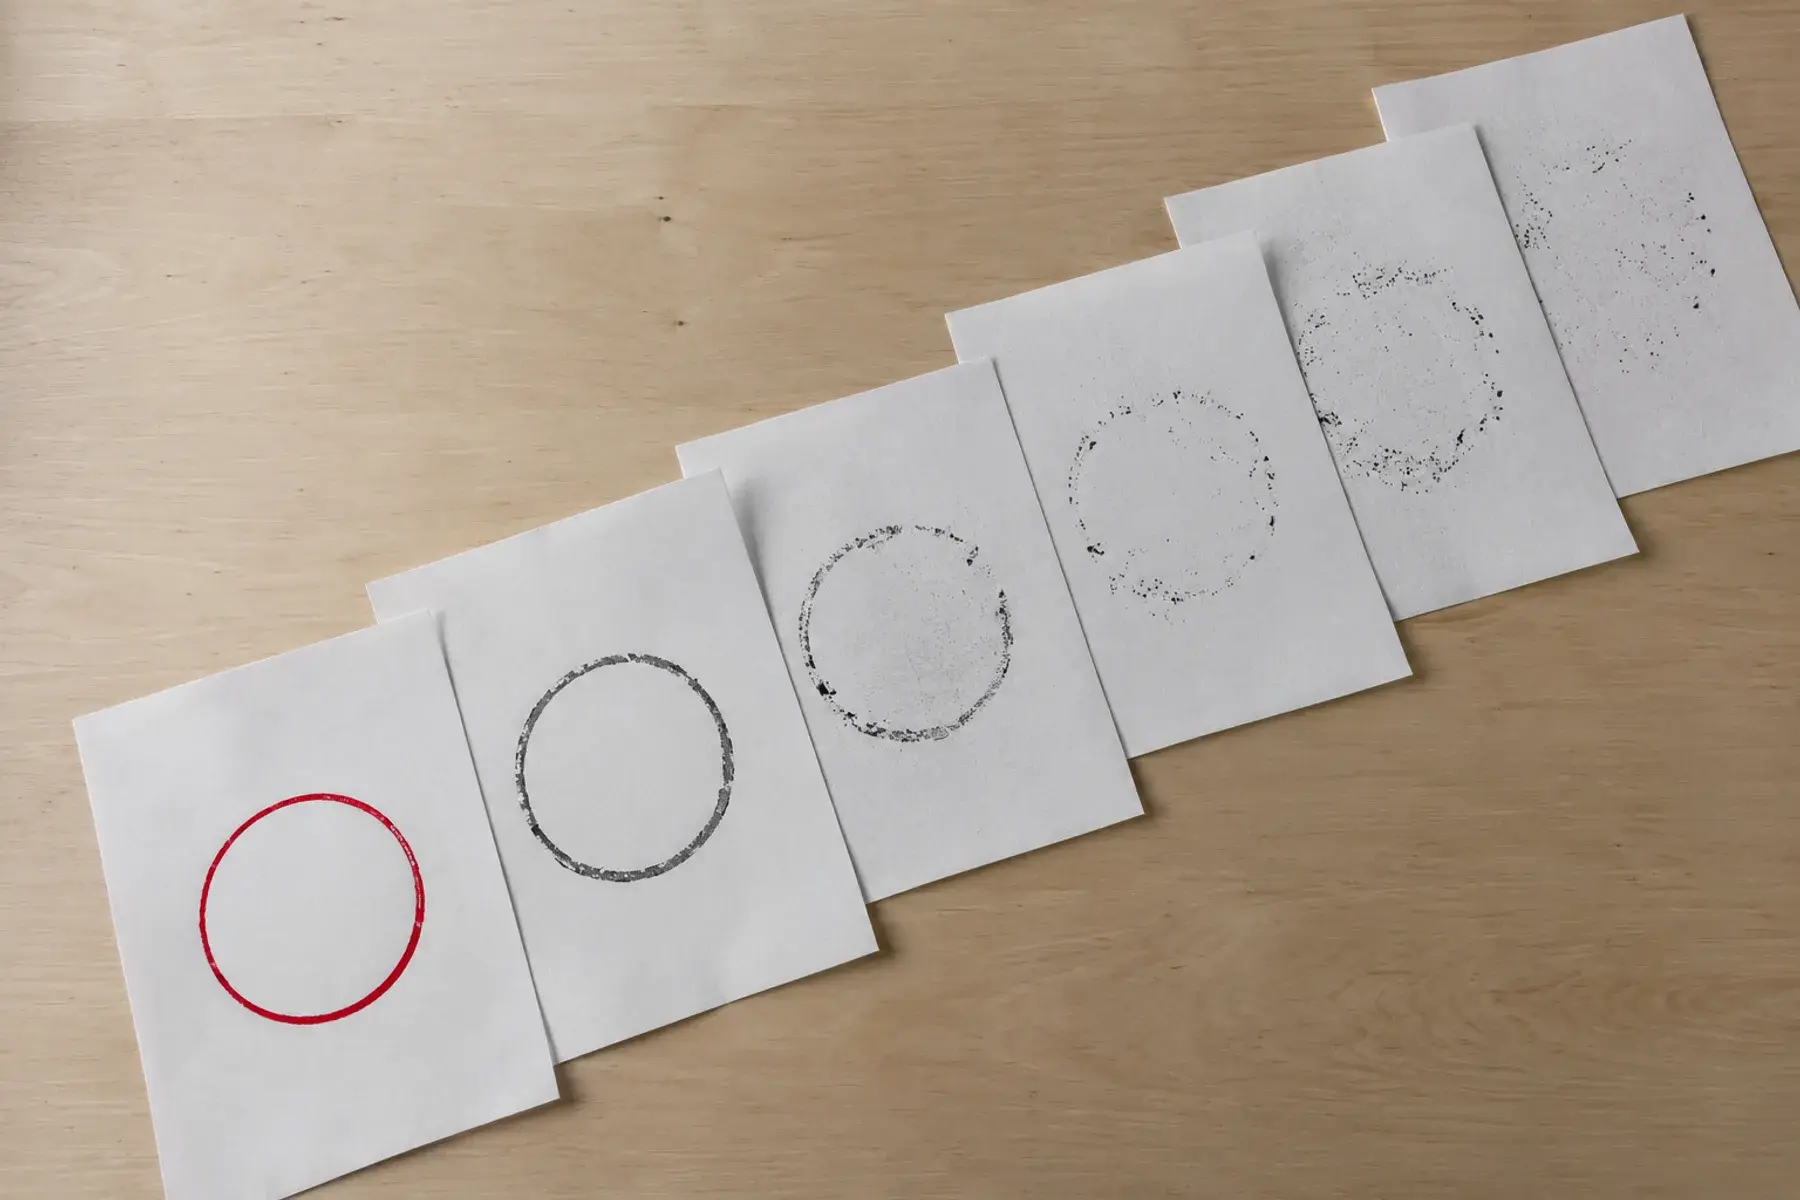
Un modello impara dai testi che trova in rete, e in rete adesso ci sono anche i testi che i modelli hanno scritto. Quando una parte del materiale di addestramento arriva da quello che un modello ha prodotto prima, il centro si rinforza e i bordi si assottigliano: le formulazioni comuni diventano più comuni, le varianti rare spariscono, e a ogni giro la varietà del materiale si restringe. Il fenomeno si studia dal 2023 con il nome di model collapse, ha una letteratura e ha anche delle controprove: chi addestra lo sa e lavora per evitarlo. Per chi lavora in azienda la conseguenza pratica è una sola, e vale comunque vada: il materiale proprio, verificato, con una persona che risponde di quello che c'è scritto, diventa la cosa che non si ricostruisce da sola.
Come un testo generato torna materiale
Il percorso è breve e non lo governa nessuno. Qualcuno scrive una scheda prodotto con un modello, la mette sul sito, e nessun campo da nessuna parte dice chi l'ha scritta. Il motore di ricerca la indicizza. Chi mette insieme un corpus per addestrare scarica il web aperto, e quella scheda entra con lo stesso peso di una scritta a mano da chi conosce il prodotto. Nessuno sta ingannando nessuno: l'etichetta manca perché il web non è stato costruito per averla.
Succede su molte categorie di testo insieme: descrizioni di prodotto, notizie locali, recensioni, risposte nei forum, documentazione tecnica, traduzioni. In quale proporzione, non lo sa nessuno con precisione, e le stime che girano preferisco non riportarle.
C'è un secondo modo, diverso e più sano, in cui i modelli imparano da testi generati. Chi addestra produce materiale sintetico di proposito, lo filtra, lo fa controllare, lo usa dove serve. Quel giro è governato e funziona. Il caso di cui scrivo è l'altro: materiale generato che rientra senza etichetta, senza che nessuno l'abbia scelto e senza che nessuno sappia quanto ce n'è.
Poi c'è la versione piccola dello stesso giro, quella che riguarda il lavoro di tutti i giorni. La scheda scritta col modello diventa la fonte della scheda successiva. Il verbale generato diventa il materiale del riassunto del trimestre. La risposta al cliente, copiata dalla risposta di prima, che era generata. Questo giro sta dentro casa, si vede, e si può fermare.
Il giro che si chiude su se stesso
Più testi generati in rete, più alta la loro quota nei corpus nuovi. Più alta la quota, meno varietà nel materiale: un modello produce quello che è più probabile dato quello che ha letto, e il più probabile sta al centro. Il centro prende peso, le forme rare lo perdono. Una parola di mestiere, un modo di dire locale, un caso tecnico che capita due volte l'anno, una posizione di minoranza. Meno varietà, più le risposte si somigliano tra loro, e più somigliano tra loro i testi che le persone pubblicano usandole. Due inversioni di segno, un giro che si rinforza da solo.
La parte che conta per chi lavora è quale varietà si perde. Non si perde il centro, che è già rappresentato in abbondanza. Si perdono i bordi: il caso raro, la lavorazione particolare, l'eccezione dentro la norma. Il bordo è esattamente il posto dove si va a chiedere aiuto, perché quello che sta al centro lo sa fare chiunque.
Il giro non corre libero, e dirlo è giusto. Chi addestra filtra, compra materiale su licenza, paga persone perché scrivano, conserva copie del web di anni passati. Alcuni gruppi di ricerca hanno mostrato che se il materiale umano continua ad accumularsi, invece di essere sostituito da quello generato, il degrado si attenua molto. Il punto interessante diventa un altro: chi possiede materiale umano che valga la pena comprare.
Il nome che la ricerca gli ha dato
Il termine nasce nel 2023, in un lavoro di Ilia Shumailov e colleghi uscito poi su Nature nel 2024. L'esperimento si racconta in una riga: si addestra un modello, lo si fa produrre, si addestra il modello successivo su quella produzione, e si ripete. A ogni generazione la distribuzione si stringe, le code si perdono prima del resto, e dopo qualche giro il modello produce un ristretto di se stesso. Risultati nella stessa direzione sono stati descritti anche per i generatori di immagini.
Quello che la ricerca non dice è altrettanto importante. Non dice che i modelli di oggi stiano collassando. Gli esperimenti costruiscono una condizione di laboratorio, in cui il materiale vecchio viene sostituito invece di essere accumulato, e servono a vedere il meccanismo in forma pura. Fuori dal laboratorio ci sono filtri, dati su licenza, lavoro umano pagato, e il meccanismo è attenuato. Resta un'indicazione di direzione, ed è il motivo per cui ne scrivo: la varietà del materiale si comporta come una risorsa, e le risorse si consumano quando nessuno le rinnova.
Il restringimento si vede tardi
Dentro un'azienda il restringimento non arriva come un allarme. Arriva come una sensazione, mesi dopo: le risposte si somigliano tutte, il cliente dice che quella cosa l'ha già letta da qualche parte, la scheda tecnica nuova sembra quella del concorrente, chi scrive non riconosce più il proprio modo di dire le cose. Nessuno di questi segnali ha una data.
Un segnale senza data produce la correzione sbagliata, e di reazioni ne ho viste due, simmetriche. La prima è il divieto: da oggi niente modelli nei testi che escono. Tiene tre settimane, poi il lavoro si accumula e qualcuno ricomincia di nascosto, perché il divieto non ha cambiato la quantità di testo da produrre. La seconda è la riapertura totale, con la sensazione di aver perso tempo, e sei mesi dopo la sensazione iniziale torna identica.
Il modo che funziona non guarda la sensazione. Mette un controllo nel punto dove il testo nasce: una regola per tipo di testo, un passaggio di verifica con un nome e una data. Così non c'è nessuna misura da correggere, perché il materiale non si appiattisce in partenza.
Il materiale con una fonte umana
Il materiale verificato è un livello, e si comporta come tutti i livelli. Sale quando qualcuno scrive una scheda e qualcun altro la controlla, mettendoci il nome. Scende quando un prezzo cambia, una norma cambia, una procedura smette di essere vera, e nessuno avvisa. Un listino del 2023 è ancora un file; come materiale verificato è uscito dalla vasca mesi fa.
Materiale con una fonte umana, in concreto, è questo. Una misura presa da voi, con la data e il nome di chi l'ha presa. L'intervista a chi fa quel lavoro da vent'anni, registrata e trascritta. La foto della macchina, il disegno, il verbale di collaudo. L'obiezione del cliente scritta con le parole che ha usato lui. Il verbale di riunione con i nomi di chi c'era. La prova che avete fatto e cosa è venuto fuori, compreso il caso in cui è andata male.
Queste cose hanno tre proprietà che il materiale raccolto in rete non ha. Non stanno nel corpus di nessuno. Si verificano con una telefonata, perché c'è una persona che risponde. E hanno una data, quindi si sa quando andranno ricontrollate.
C'è anche una ragione pratica che vale oggi, a prescindere da come andrà la faccenda dei corpus. Quando chiedi a un modello di scrivere usando il tuo materiale, l'uscita smette di essere media, perché il materiale non è medio. Due aziende che usano lo stesso strumento sulle stesse domande ottengono risultati diversi, e la differenza sta quasi tutta in cosa gli hanno dato da leggere.
Una fonte originale vale anche nel contenuto che compete per l’attenzione. Dentro un processo aziendale, però, la provenienza da sola non basta: servono responsabili e criteri di verifica dell’output, senza presumere che un testo umano sia necessariamente corretto.
Cosa tengo e come lo tengo
Tre colonne accanto a ogni pezzo di materiale che altri riusano: cosa dice, chi l'ha verificato, quando. Una riga per voce, in un foglio o nel gestionale, dove tutti la vedono.
Un segno di provenienza dentro il file. Scritto col modello, verificato da chi, in che giorno. Dieci secondi adesso. Ricostruirlo fra un anno è una giornata di lavoro, e spesso non è possibile affatto.
Una regola su cosa è fonte. Il listino, le schede prodotto, le procedure, le risposte tipo ai clienti: quelle sono fonti, e una fonte passa da una persona prima di diventarlo. Tutto il resto si può generare con mano libera, perché nessuno lo riuserà come materiale di partenza.
Una cosa da non fare: alimentare il proprio materiale con il proprio materiale generato, senza un passaggio umano nel mezzo. È il giro di questo articolo in versione aziendale, e chiuderlo costa una firma.
Il giro grande, quello della rete, non lo chiudo io e non lo chiudi tu. Il giro piccolo, quello che passa dentro la tua azienda, si chiude con una colonna in un foglio e il nome di una persona accanto. Chi avrà materiale proprio e verificato fra due anni avrà l'unica cosa che non si genera: qualcosa da dire che qualcuno ha controllato.
Riferimenti e limiti dell’analogia
Il risultato sperimentale citato è AI models collapse when trained on recursively generated data, di Shumailov e colleghi, pubblicato su Nature nel 2024. Le condizioni di addestramento contano: un successivo lavoro sull’accumulo di dati reali e sintetici mostra un esito diverso dalla semplice sostituzione ricorsiva. Il confronto con l’archivio di un’azienda è una mia analogia organizzativa, non la dimostrazione che un testo riscritto in ufficio produca lo stesso fenomeno del modello di laboratorio.
Continua a leggere
Il contenuto che nessuno legge: cosa resta quando pubblicare costa poco
Se tutti pubblicano il triplo, l'attenzione resta quella e il valore per pezzo scende. Il giro della saturazione, e cosa regge quando il volume non basta.
Come mai ChatGPT ti dà sempre ragione
I modelli sono addestrati anche a piacere a chi legge, e la domanda che contiene già la risposta chiude il cerchio. Come chiedere senza farsi confermare.
Quanto costa davvero un'ora risparmiata con l'AI
L'ora risparmiata nella scrittura torna come verifica, e come lavoro di chi rifà. Come misurare il ciclo intero, dalla richiesta al risultato accettato.