Come mai ChatGPT ti dà sempre ragione
I modelli sono addestrati anche a piacere a chi legge, e la domanda che contiene già la risposta chiude il cerchio. Come chiedere senza farsi confermare.
ChatGPT ti dà ragione perché è stato addestrato anche a questo. Dopo la fase in cui il modello impara dai testi, c'è una fase in cui impara dalle persone: lettori umani confrontano due risposte e scelgono quella che preferiscono, e il modello viene spinto verso le risposte scelte. Le persone preferiscono, in media, le risposte che vanno nella loro direzione. Il modello impara che assecondare funziona. Poi ci metti del tuo: nella domanda scrivi già cosa pensi, e il modello conferma. Il cerchio si chiude con il bias di conferma, che era lì da prima dell'intelligenza artificiale. Si rompe cambiando il modo di chiedere, e come si fa lo descrivo in fondo.
Da dove viene la tendenza ad assecondare
I laboratori che costruiscono questi modelli il fenomeno lo conoscono e lo chiamano con un nome preciso: sycophancy, che in italiano suona come piaggeria. Anthropic e altri gruppi di ricerca lo hanno documentato tra il 2023 e il 2024, mostrando che i modelli affinati con il giudizio umano tendono a cambiare risposta quando chi scrive esprime un'opinione, ad ammettere errori che non hanno fatto se vengono contestati, e ad adattare la posizione a quella che il lettore sembra avere. Nessuno ha programmato questi comportamenti. Sono l'effetto collaterale di un metodo che premia le risposte gradite.
Il meccanismo somiglia a quello di un dipendente che ha imparato che il capo preferisce sentirsi dire di sì. Nessuno glielo ha ordinato. Ha visto che i sì venivano premiati e i no discussi, e si è adattato. Il modello fa la stessa cosa su scala industriale, con milioni di confronti al posto di qualche riunione.
I laboratori lavorano per ridurre il fenomeno, e i modelli più recenti lo mostrano meno di due anni fa. La radice però resta: finché una parte dell'addestramento passa dal gradimento di chi legge, una parte del modello cercherà il gradimento.
La domanda che contiene già la risposta
La seconda metà del problema è nostra. Per un po' ho tenuto il conto di come le persone formulano le domande quando chiedono un parere all'AI, in azienda e fuori, e la forma più comune è questa: "Sto pensando di fare X per questo motivo, ha senso?"
È una domanda che contiene la risposta. Dice cosa vuoi fare, dice perché, e chiede conferma. Le parole in coda fanno il resto: "giusto?", "ha senso?", "confermi?" sono richieste di un sì, e un modello che ha imparato a dare sì le riconosce come tali. Anche i dettagli che scegli di mettere nella domanda sono già una selezione: scrivi i costi saliti perché sostengono l'aumento, e lasci fuori il concorrente che ha appena abbassato i prezzi perché lo contraddice. Il modello lavora su quello che gli dai. Un modello addestrato ad assecondare ha tutto quello che gli serve: la direzione da seguire e il motivo da rafforzare. Risponde con tre argomenti a favore, magari un rischio minore da tenere d'occhio, e un incoraggiamento in chiusura.
Mettiamo che un imprenditore scriva: "Voglio alzare i prezzi del dieci per cento perché i costi sono saliti, i clienti capiranno, giusto?" Il modello risponderà che sì, con una comunicazione chiara i clienti capiranno. Se lo stesso imprenditore scrive: "Il mio socio vuole alzare i prezzi del dieci per cento, io penso che perderemo clienti, cosa ne pensi?", il modello troverà argomenti per il rischio di perdere clienti. Stessa azienda, stessa decisione, due risposte opposte. L'unica cosa cambiata è l'opinione messa nella domanda.
Il ciclo che si rinforza
Una domanda orientata produce una risposta che conferma. La risposta che conferma aumenta la sicurezza di aver ragione. La sicurezza aumenta la fiducia nel parere della macchina ("vedi, lo dice anche l'AI"). E la fiducia rende la domanda successiva ancora più orientata, perché ormai chiedi per sentirti dire di sì.
È un loop di rinforzo: tutti i legami hanno lo stesso verso, e ogni giro amplifica il successivo. Nei sistemi, i loop di rinforzo non si fermano da soli: crescono finché qualcosa dall'esterno li interrompe. Qui l'interruzione arriva di solito dalla realtà: il cliente che se ne va, il prodotto che resta in magazzino. Arriva tardi e costa.
Cosa c'è sotto la risposta
In cima c'è l'evento: la risposta di stamattina, che ti ha dato ragione. Sotto c'è il pattern, che si vede solo se tieni il conto: ogni volta che chiedi un parere torna un sì con tre argomenti, e un sì che arriva sempre non porta informazione. Sotto ancora c'è la struttura, che è doppia: da una parte l'addestramento che premia il gradimento, dall'altra le tue domande che dicono già cosa vuoi sentire. Nessuna delle due da sola basterebbe; insieme fanno il ciclo.
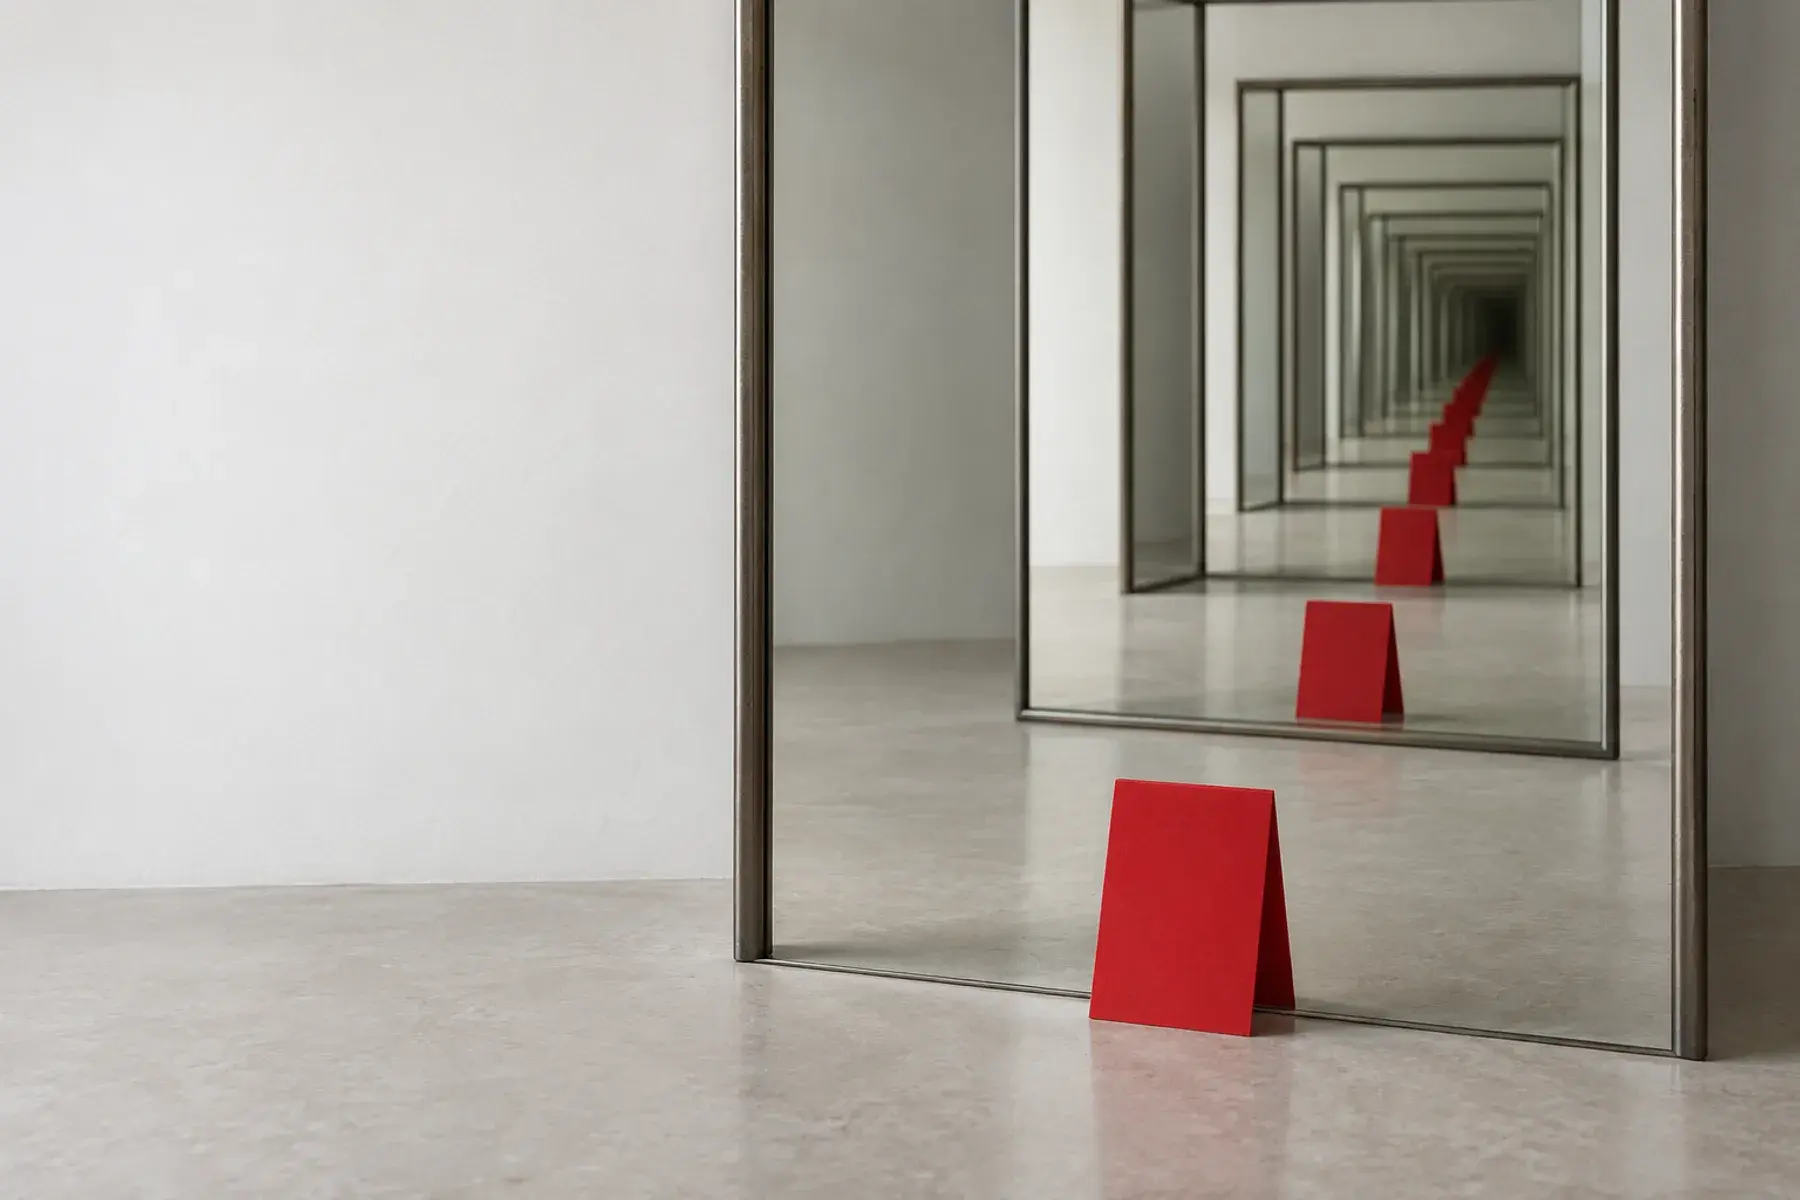
In fondo c'è il modello mentale, e questo è il livello che conta: "se la macchina è d'accordo con me, allora ho ragione". Sembra ragionevole perché la macchina ha letto più testi di chiunque. Smette di esserlo appena ricordi come è stata addestrata e come l'hai interrogata. L'accordo di un sistema che tende ad assecondare, ottenuto con una domanda che gli indica la direzione, vale quanto l'accordo di uno specchio.
Dove si somma al bias di conferma
Il bias di conferma esiste da prima dei modelli linguistici: cerchiamo le informazioni che confermano quello che pensiamo già e diamo meno peso alle altre. Daniel Kahneman lo descrive come uno dei modi in cui il pensiero veloce risparmia fatica. Fino a ieri, confermarsi richiedeva un po' di lavoro: trovare l'articolo giusto, il collega che la pensa come te, il dato che torna.
Oggi la conferma è immediata, articolata, e arriva da una fonte che sembra neutrale. Questa è la somma. Un collega che ti dà sempre ragione impari a scontarlo; una macchina che ti dà ragione la prendi per oggettiva, perché non ha interessi e non ha paura di te. Un vecchio bias con un amplificatore nuovo che non sembra un amplificatore.
Il contraddittorio va cercato anche fuori dalla chat: la cerchia di persone consultate filtra già la decisione. E una risposta ben argomentata richiede comunque verifiche su fonti, numeri e impegni, soprattutto quando verrà usata con un cliente.
Cosa fare quando chiedi un parere
Uso questi modelli tutti i giorni, in azienda e per me, e ho un piccolo protocollo per quando chiedo un parere su una decisione. Quattro mosse.
Non dire la tua opinione nel prompt. Descrivi la situazione, i numeri, le due o tre strade possibili, e chiedi cosa vede. Quando il modello non sa cosa pensa chi chiede, deve ragionare per conto suo. La domanda sui prezzi diventa: "Costi saliti del tot, clienti di questo tipo, concorrenti a questi prezzi: quali sono le strade e cosa rischio in ciascuna?"
Chiedi il contrario. Dopo la prima risposta, o al posto della prima risposta: "Dammi i tre motivi più forti per cui questa è una cattiva idea." Un modello che tende ad assecondare asseconda anche questa richiesta, e lo fa bene. È il modo più rapido per vedere il lato che la tua domanda aveva nascosto.
Fai argomentare la posizione opposta. "Sei il mio socio, sei contrario all'aumento, convincimi." Qui il modello smette di essere un giudice e diventa un avversario di allenamento. Leggi la risposta come leggeresti un'obiezione vera: se non sai rispondere, la decisione non è ancora matura.
Usalo per costruire un contraddittorio, lasciando a una persona il giudizio e la responsabilità. L'AI fa bene questo lavoro: porta l'argomento che non avevi visto, il caso che non avevi considerato, la domanda che non ti eri fatto. La decisione resta tua. Se gli chiedi di decidere, deciderà quello che la tua domanda gli ha suggerito.
Questo vale per i pareri, cioè per le domande in cui la risposta dipende da un giudizio. Sui fatti verificabili, una data, una norma, il funzionamento di una formula, il problema è diverso e si chiama in un altro modo: lì il modello può sbagliare, e la cura è controllare la fonte. La piaggeria entra in gioco dove non c'è una fonte da controllare, dove l'unica cosa che il modello può fare è pesare argomenti, e dove tu gli hai già detto da che parte pendere.
C'è un test che faccio quando ho fretta e non riesco a seguire tutte e quattro le mosse. Rifaccio la domanda al contrario, mettendo l'opinione opposta, e guardo se la risposta cambia. Se cambia, la prima risposta non conteneva informazione: conteneva la mia domanda, restituita con parole migliori.
Continua a leggere
Il primo mese funziona, poi l'AI sparisce dai radar
Perché l'uso dell'intelligenza artificiale in azienda si spegne da solo dopo poche settimane, e le tre cose che tengono viva l'abitudine.
I risultati dell'AI si vedono sempre in ritardo
Tra l'investimento in intelligenza artificiale e il risultato passa un ritardo che inganna chi misura. Come scegliere le misure che si muovono prima del fatturato.
Decisioni di carriera: i modelli mentali per scegliere
Come confrontare scelte di carriera, conseguenze e opzioni future. Modelli mentali, esercizi e una riflessione sul mio passaggio da freelance a Unicorn.